Про кроссфункциональность и ИИшенку

Хотел недавно обсудить с юными программистами, что такое «кроссфункциональная команда», о которой говорит нам Scrum Guide, но неожиданно обнаружил, что «работающие по скраму» молодые люди с основными положениями этой методологии не знакомы — но не пропадать же заготовленной проповеди? Тем более, не далее чем сегодня в телеге наткнулся на пару обсуждений нашего будущего с иишенкой или без — и тут тоже есть, что сказать.

Начнем, разумеется, с первоисточников — а именно с формулировки из Scrum Guide, где обсуждается, как должна быть устроена «команда», цитирую:

Scrum Teams are cross-functional, meaning the members have all the skills necessary to create value each Sprint.

Программисты и вырастающие из них малокомпетентные руководители любят ее извращать (одновременно притаскивая еще одну фразочку — Scrum recognizes no titles for Development Team members other than Developer — из старых версий руководства, в версии 2020 года ее убрали, потому что она создавала сложности с пониманием) — мол, каждый член команды должен обладать всеми необходимыми навыками, а поэтому можно вешать любому какие угодно задачи, и может быть, в программировании это и так — но вот давайте посмотрим на процесс разработки несложного электронного устройства, лучше даже чего-то IoT’шного. Возьмем простой метод:

Прикиньте на пальцах количество направлений, в которых вам надо иметь компетенции. Умножьте на два. Получите число людей, которых вам надо собрать в коллектив и удерживать в нем для того, чтобы обеспечить стабильную разработку.

Какие специалисты понадобятся для этого, кто будет «работать руками»? Загибайте пальцы:

— надо уметь разрабатывать принципиальные схемы;
— надо уметь трассировать печатные платы (да, это немного другая специализация, иногда один человек умеет делать и то, и другое, иногда — нет);
— надо уметь программировать под микроконтроллеры;
— надо уметь программировать под «desktop» (в кавычках, потому что это могут быть и какие-то cli-утилитки, и gui-шные приложения, и вообще что угодно, типа питоновского скрипта для автоматизированного тестирования);
— надо уметь программировать бекенд для веба;
— надо уметь программировать «фронтенд» (опять же, название условное, это может быть и классический веб-сайт, и приложение на Android);

— заметьте — я уже перечислил чисто технические специальности, при этом пальцев на одной руке уже не хватает, а на выходе мы получим «продукт, сделанный программистами» — так что добавьте сюда пару дизайнеров («индустриального» и веб-); конструктора и/или технолога, если аппаратная часть представляет собой что-то сложнее ардуины; быть может, вам понадобится несколько тестировщиков; в конце концов, кто-то должен в конечном итоге этот ваш «продукт» продать, так что давайте не забывать и про Business Development, Sales and Marketing. Ах да, я не упомянул самого главного — кто-то должен представлять себе, что же в итоге мы хотим получить, и как-то организовывать работу этой толпы — то есть никак нельзя обойтись без менеджера проекта, или в скрамовской терминологии — Product Owner.

Разумеется, это не имеет ничего общего с «кроссфункциональностью» в ее извращенном понимании, инженер-электроник, занимающийся трассировкой печатных плат, никогда не сможет хотя бы удовлетворительно писать бекенд-приложения, например — а бекендер вряд ли справится с задачей «перерисовать принципиальную схему ардуины, добавив вот то и убрав это». Кроссфункциональность в организации команды здесь противопоставляется функциональному делению — немного на другом примере разница описана у О. Матвейчева в «Уши машут ослом» — прочитайте главку «Почему американцы побеждают», там кроссфункциональный принцип описан в разделе про «принцип спагетти» и противопоставляется «пирамидально-функциональному», когда каждое отдельное направление выделяется в отдельное подразделение со своим руководителем — скажем, в гипотетической большой фирме, разрабатывающей много вышеописанных IoT’шных проектов, был бы выделен отдел схемотехников, отдел программистов (а может быть даже два, а то и три разных), обязательно — отдел тестировщиков, и так далее. Дальше в каждом таком отделе начинают «внедрять Agile» — и получаются именно характерные для такого подхода команды из одинаковых взаимозаменяемых узких специалистов, «людей-функций»; взаимодействие между командами максимально затруднено. С другой стороны, когда «все члены команды обладают одинаковыми навыками» — именно эти одинаковые навыки объявляются «всеми необходимыми». Для типовых хорошо формализуемых задач, вроде конвейерного аутсорса всяких оперденей для внешнего заказчика, оно может даже работать — но к кроссфункциональности, к «принципу спагетти», это никакого отношения не имеет.

Кстати, вопрос — а кто конкретно в Scrum отвечает за то, что команда обладает необходимыми навыками, кто должен следить за этим и при необходимости принимать кадровые решения — нанимать недостающих специалистов, организовывать обучение имеющихся, и так далее?

Но впрочем, из мира больших компаний давайте вернемся к всякой мелочевке, буквально к стартапам :) Типовой путь разработки того же IoT’шного устройства в мелкой фирмочке выглядит примерно так — есть один «гениальный директор/генитальный конструктор», который и в инженерии имеет довольно широкий кругозор (как минимум способен удовлетворительно, «на троечку», закрыть сразу несколько пунктов из перечисленных выше), и сумел ухватить какую-то чисто бизнесовую идейку, которую «закрыл» самостоятельной (или буквально с одним-двумя единомышленниками) разработкой востребованного на рынке прибора. А дальше начинается боль, потому что «техническую» сторону вопроса хорошо бы кому-то скинуть делегировать, «генеральный конструктор» смотрит на узких специалистов и офигевает — хотя это я уже описывал!

И вот тут нам на помощь приходит современная ИИшенка! Говорят, что всякий там Claude Code вполне успешно заменяет «младшего разработчика», который по достаточно точным указаниям в несколько итераций может реализовать несложный изолированный кусок кода, к которому не предъявляется каких-то специфических требований. Превратить CLI в GUI? Можно дать задачку «инженеру-программисту 3 категории» (он же «джун») — а можно скормить ее иишенке и получить результат ничем не хуже. Какая-то мелкая автоматизация, «типовой» код, в конце концов, тот же boilerplate — в общем, задачи, хорошо формализуемые и не требующие понимания «проекта в целом» уже не требуют участия узкоспециализированного программиста, к тому же иишенка не жалуется на жизнь и несправедливость мира, который не желает оценить по достоинству творческую работу «программиста под Android» (которая сводится, скажем, к превращению текстового описания апишечки в более формализованное, на каком-нибудь Retrofit).

Так вот, большинство действительно успешных применений LLM’ок — это замена редко нужных узких специалистов их иишным «аналогом». В сущности нет разницы между программистом, берущим задачку из Jira, а затем отдающим ее на code-review, и делающей то же самое нейросеткой (забавно, кстати, что это по сути перевод с человеческого языка в код, а именно для перевода LLM’ки и были придуманы); чем лучше формализуется такая задача, тем проще отдать ее железному болвану. И вот тут вырисовывается интересный критерий, как определить, заменит ли вас ИИ или нет — если в вашей работе в какой-то степени требуется давать указания подчиненным или коллегам, а потом проверять результаты работы — то ИИшенка заменит скорее коллег или подчиненных, но не вас; а вот если ваша работа, как программиста-кнопкодава, сводится к перекладыванию карточки на канбан-доске из графы «в работе» в графу «можно проверять» — то у меня для вас плохие новости!

Ну и да, плохие новости у меня для тех кнопкодавов, которые занимают агрессивно-оборонительную позицию по отстаиванию «своей зоны ответственности». Скажем, какие перспективы у условного «аишника», который практически демонстративно отказывается от изучения предметной области, не хочет отличать Telnet от TCP и вдаваться в нюансы маршрутизации в IP-сетях? Если «аишная» задача ставится и проверяется в терминах, понятных сетевикам — то какая этим сетевикам разница, будет ли построенная ML-модель сделана белковым data scientist’ом (это такое модное название для программиста на Python, который умеет перекладывать данные между Pandas и Torch) или нейросеточкой? Да собственно, никакой.

Мемы и гигиена

Увидел сегодня сайтик, откуда в околоайтишную среду пошла лексика вроде «кабанчик» (или, со смесью страха и подобострастия — «Иван Кабаныч»), «гречневые» и прочее подобное. Про то, почему меня туда занесло — потом, а пока напишу одну недомыслишку про вот такие определения.

Если подумать — то это и есть те самые «мемы» из книжки Докинза, причем довольно примитивные — буквально мозговые вирусы, которые легко подцепить и начать распространять. Но что опасно — эти мемы претендуют на то, чтобы объяснять «как устроен мир», хотя делают это плохо, в лучшем случае «на троечку». На основании этих «объяснений» заразившийся формирует свою кривую картину мира, причем еще активно ее этими мемами распространяет.

Можно ли всерьез обсуждать, скажем, международные отношения с человеком, понабравшимся в тусовке галковскоманов фразочек про «новиопов» и «люди работают»? Можно ли говорить про экономику с тем, у кого на любые мнения об оплате труда готово ироничное «да-да, русским деньги не нужны, понятно»? А ведь есть чатики и каналы, которые эту заразу активно распространяют, причем целенаправленно. Соблюдайте информационую гигиену — не читайте эти помойки, если читаете — вымойте глаза и уши с мылом, с встречающимися вам носителями обращайтесь, как с людьми, чихающими в общественном месте — отодвиньтесь в сторонку или используйте СИЗ в виде синей ковидной масочки :)

Когда доел салатики, а бухлишко еще осталось

Решил немножко вернуться к недоделанным прожектам прошлых лет, но вот думаю, не впадаю ли в грех хипстерства, не сильно ли ебанатское решение придумал.

В общем, есть ПэКа с линуксом и подключенный к нему по USB десяток разных микроконтроллеров (в основном STM32 и nRF52) с отладчиками (отладчики какие попало, есть J-Link, STLink и даже CMSIS-DAP — в общем, разные); хочется удаленно прошивать их, перезагружать и может быть даже отлаживать через веб-приложение на Flask. Так исторически сложилось :), что приложенька умеет делать все это через GDB (pygdbmi или как-то так) и GDB-шные команды вроде monitor.

Так вот, «ценное техническое решение» видится таким — запускаю на этом ПэКа десяток копий openocd, постоянно работающих, с интерфейсом gdb на разных портах (3333, 3334, 3335 и так далее), возможно, с чуть разными конфигурационными файлами (для разных пар отладчик-микроконтроллер), и тем самым «сводим задачу к предыдущей». А чтобы эти openocd не перезапускать ручками всякий раз (бывает, что они падают по каким-то причинам) — хочу использовать supervisord, его в каком-то мануале по Flask рекомендовали для запуска питоновских веб-приложений, так что он там будет.

Собственно два вопроса — нормально ли держать запущенными кучку openocd, и нормально ли пользоваться supervisord?

Про Android

С периодичностью раз в несколько лет приходится иногда вспоминать программирование под Android — и каждый раз попытка слегка обновить написанную десяток лет назад небольшую программку превращается в забег по граблям. Вот и в этот раз воюю с версиями Android SDK, Android Studio, Gradle и собственно самого Android, пытаясь «догнать» обновления системы за последние несколько лет.

Так вот, в процессе понял, почему софт под Android (и возможно, «под мобилки» вообще) в среднем получается настолько кривым и уебищным. Программист, пишущий под это говнище, ежедневно видит кривую IDE, раздувшуюся от неприлично большого количества всяких бесполезных «фич«, неотделимую от нее систему сборки, зоопарк из версий JDK, плагинов, библиотек, чего угодно, без ведома автора подсасывающийся из интернетов — и у него складывается впечатление, что это хорошо, это нормально, так можно жить — и в результате имеем андроидные приложеньки по несколько десятков и даже сотен мегабайт, все функции которых сводятся к дерганию чужих API, и соответствующих «программистов«.

Обиженки из опенсорса

Есть такой довольно древний проект эмулятора еще более древних вычислительных платформ — SIMH. Залез я на днях в его репозиторий и увидел в лицензии очень странную формулировку (и еще кучку каких-то разъяснений):

Any use of this codebase that changes the code to influence the behavior of the disk access activities provided by sim_disk.c and scp.c is free to do that as long as anyone doing this is explicitly not licensed to any subsequent changes to any part of the codebase in the master branch of the git repository (https://github.com/simh/simh) made by Mark Pizzolato after the LICENSE.txt was added to the master branch of repository. Changes that qualify for this restriction at least include: changing the behavior or default of SET AUTOSIZE/NOAUTOSIZE, or any code in scp.c and sim_disk.c or any simulator components that use the sim_disk routines.

Что это могло бы значить? Сначала перебирал в голове мысли о том, что функциональность дисковой подсистемы ограничили специально, из-за каких-то «требований правообладателя» — мол, ваш эмулятор может быть использован для того, чтобы пиратить какой-то древний, но очень дорогой софт. Но реальность оказалась куда смешнее:

https://github.com/simh/simh/issues/1059

Оказывается, что вот этот самый Mark Pizzolato добавил в проект какую-то сомнительную херню, а когда ему начали говорить, что эта херня очень сомнительная и портит что-то у пользователей эмулятора — обиделся и запретил убирать эту херь из проекта. В результате более здравомыслящие участники проекта запилили собственный форк — OpenSIMH, а программист-обиженка остался в старом репозитории в гордом одиночестве.

А вот немного математики принесу

Господа программисты, погонщики программистов и приравненные к ним, вопрос возник. Вот есть, предположим, описанный вот так некий алгоритм, попертый отсюда:

https://jmlr.csail.mit.edu/papers/volume12/weng11a/weng11a.pdf

Собственно, вопрос: должен ли средний питонист понимать написанное, или между программистом и этой статьей непременно должен быть специально обученный человек, который перенесет это на псевдокод/фортран/питон/whatever?

Страшные мысли

Вот тут иностранный айтишник рассуждает про «сложность систем» и в предпоследнем абзаце практически приходит к определению «идеальности по ТРИЗ» — «система отсутствует, а ее функции выполняются»:

https://olano.dev/blog/a-note-on-essential-complexity

В последнем абзаце, правда, он тут же до усрачки пугается этой мысли и вспоминает про «экономические интересы» программистов — ведь как это так, за отсутствующую систему ему денег платить не будут!

Про CI/CD

Прочитал студентам проповедь про CI/CD в embedded, поделюсь и тут:

Как учат нас всякие нормативные документы — возьмем, например «авиационный» стандарт DO-178B или в русском переводе — КТ-178B — «интеграция» — это процесс, в рамках которого «исполняемый код загружается в целевой вычислитель» (раздел 5.4) — то есть примерно то, когда вы в Riot выполняете команду make flash или в каком-нибудь красивом IDE типа Keil или IAR (ну или в крайнем случае Arduino IDE) нажимаете кнопку «Run», которая делает то же самое — ваш проект компилируется и загружается в подключенное к вашему компьютеру через отладчик устройство. Это может быть устроено немного более сложно, но пока такого представления об этом всем достаточно.

Дальше, даже если вы делаете это все вручную, в том или ином виде у вас происходит «верификация», в терминах того же стандарта — вы убеждаетесь, что программа работает так, как вы представляете нужным — это называется «анализом тестовых примеров, процедур и результатов испытаний». В самом простом виде — вы смотрите на мигания светодиодиков, вывод в UART, может быть, вручную выполняете какие-то операции с устройством.

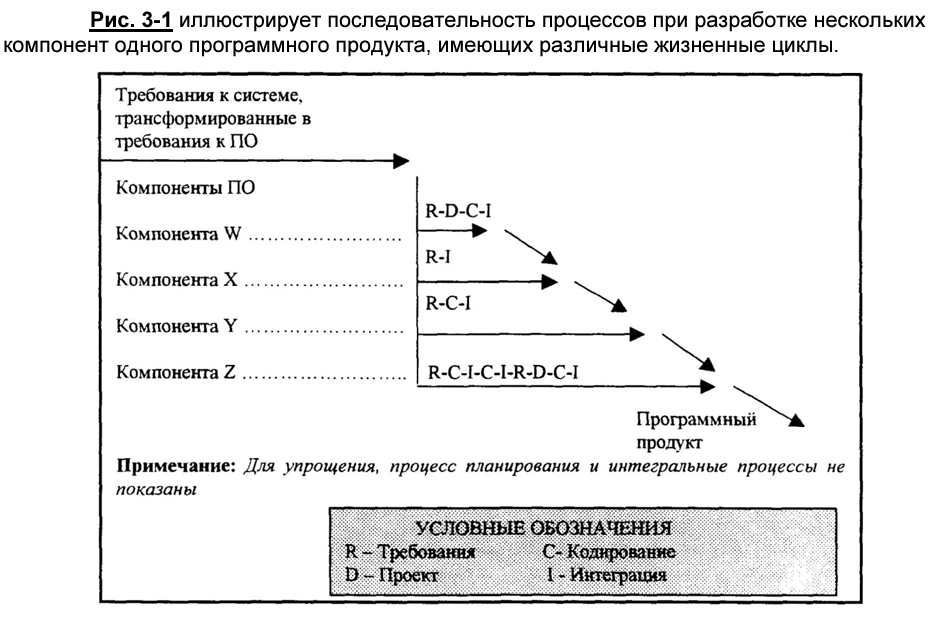
Исходя из результатов испытаний вы понимаете, что программа работает неправильно, возвращаетесь к кодированию — и все повторяется заново, стандарт описывает это словами «Процессы жизненного цикла ПО могут иметь итерационный характер, то есть, могут повторяться» — примерно так, как это показано для «компоненты Z» на этом рисунке:

«Наивный» подход к разработке ПО (свойственный инженерам-электронщикам, кстати говоря) — это то, что показано для «компоненты W» — формулируем требования, выдаем их кодеру, он пишет код, потом заливаем его в целевое устройство, …, PROFIT! Проблема в том, что он… не работает, но при этом широко применяется, вот довольно яркое описание принятых у электронщиков рабочих процессов в программировании:

Качество кода? Ревью? Разделение задач? система контроля версий? Да о чем вы! Высрал бинарник в пизженом кейле и отдал на производство. Человек ушел, работы не приняли, новый начинает с нуля все заново.

https://mbr.livejournal.com/606449.html

Так вот, «непрерывная интеграция» — это в точности то, что сделано в Riot’овских тестах, запускающихся на базе iotlab:

— основная «ветка» безо всякого участия программиста компилируется (это результат «процесса кодирования», пункт 5.3.2 в документе), причем «эталонным» компилятором (я видел, как некоторые проекты «ломались» от смены версий gcc);
— выполняется «процесс интеграции» (раздел 5.4);
— дальше проводится то, что в КТ-178 называется словом «испытания» (программисты скорее будут использовать слово «тестирование») — «выхлоп» программы сравнивается с ожидаемым.

Хочу обратить внимание, что верификация этим не исчерпывается, это немного более сложная штука, но как минимум часть задач верификации тестированием закрывается. Главное — то, что все это делается полностью автоматически, и программист не может намеренно «обойти» эти процессы, потому такая интеграция и называется «непрерывной».

Ну а так как результаты испытаний — это, в том числе, и входные данные для процессов разработки («устранение ошибок – это мероприятия процессов разработки») — то они становятся такими же «непрерывными» — как для «компоненты Z» на рисунке перемежаются «кодирование» и «интеграция» (а то и вовсе по результатам очередной интеграции и испытаний мы возвращаемся к разработке требований и перепроектированию).

В embedded это все особенно ярко видно, потому что «целевой вычислитель» — вот он у вас, в руках или на столе в виде отладочной платы.

Понятно, что все эти вещи можно делать разными средствами — да хоть даже «вручную» — написал код, выполнил команду make или нажал Compile, отдал получившийся бинарник тестировщику (и все это еще оформить документально журналом по принципу «сделал — запиши, не сделал — запиши два раза» — в принципе, и такие «процессы» возможны), но если можно автоматизировать эту работу — то почему бы и нет? Заодно в какой-то степени из процесса испытаний исключается человеческий фактор, все, что можно проверить автоматически — будет проверено, в идеале — для каждого существенного изменения в вашем гитлабовском репозитории (а контроль версий на языке тех же стандартов входит в то, что называется «управлением конфигурациями»).

Собственно, именно это и называется «непрерывной интеграцией», а вовсе не бездумное использование GitLab, Docker и прочих Ansible — важны не инструменты, а то, что вы с помощью этих инструментов делаете. Более того, если строго следовать требованиям КТ-178 — то используемые в процессе валидации инструменты должны быть «квалифицированы», то есть разработаны в рамках предъявляемых стандартом требований. Разумеется, такие программные продукты тоже есть, стоят дорого, как и все авиационное — но возможно, и с ними в жизни придется встретиться.

Embedded, мать его

Как это, руководить проектом (пусть даже студенческим) по разработке мелкого устройства на микроконтроллере? Да очень просто:

— вчера ты шутишь про «быстрые китайские чопперы» (не мотоциклы);
— сегодня — разбираешься в нюансах работы gdbserver поверх TCP;
— завтра — еще какая-нибудь ебала вылезет.

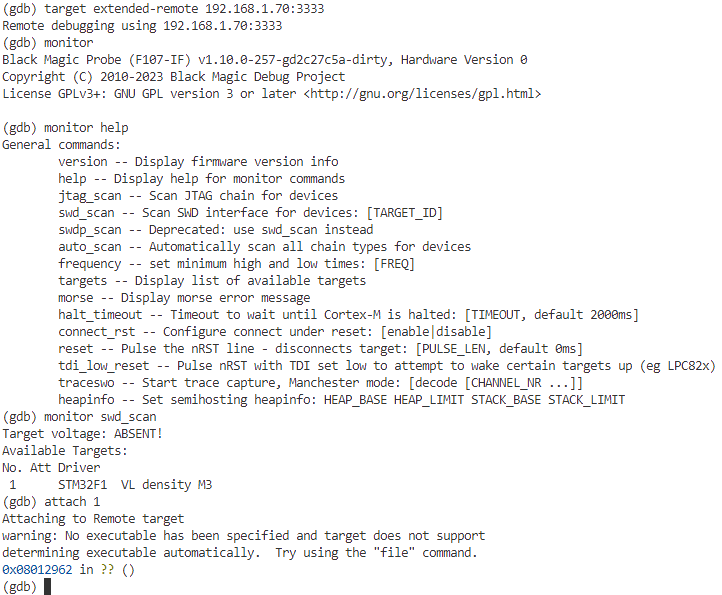
Впрочем, now it’s official — удалось прикрутить к Blackmagic Debug Probe поддержку TCP, причем нормально, а не как в ctxLink:

Дальше в планах — дальше допиливать обещанный как-то в комментах «отладчик с мониторингом энергопотребления для устройств Интернета вещей, … сочетающий в себе свойства Segger J-Link Pro, Blackmagic Debug Probe и Unwired Devices Energymon». Скорее всего, даже заопенсорсим устройство (прошивку уж точно) — хотя есть у меня обоснованные сомнения касательно всякого Open-source hardware.

Ну и в качестве развлечения — быстрый китайский чоппер (на этот раз мотоцикл):

Из твиттера про инженерию

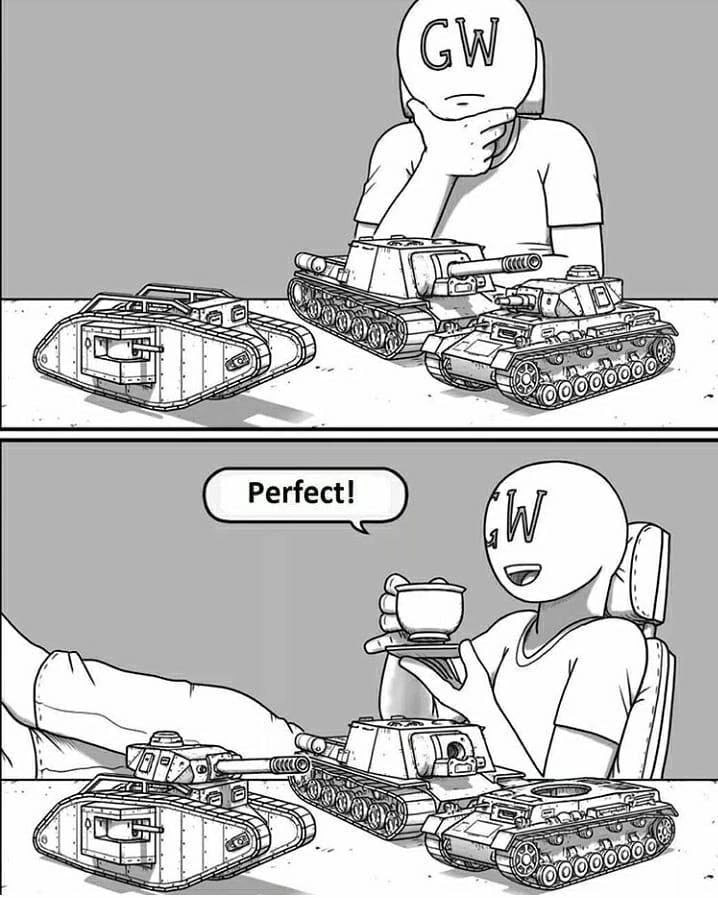
Увидел тут в твитере пост, где некая сеньорита фронтенда считала «новым и интересным» чтение ебаной документации к очередному блядскому стейт-менеджеру. Охуел и подумал — господи, какой же пиздец, когда люди считают это «новым и интересным»! Что сука характерно: как только некий класс софта получает общее название (да хоть «стейт-менеджер» этот), выбор между разными представителями этого класса определяется в первую очередь не «функциональными» соображениями, а абсолютно субьективными вещами вроде «моды» — и это еще сравнивают с инженерией! После такого отказываюсь причислять программистов к инженерам, потому что инженерии в сборке очередного программного поделия не больше, чем в поклейке танчиков из набора фирмы «Звезда».

Никогда не читайте истории успеха

Особенно — в исполнении русских бизнесменов. И нет, я сегодня не о вылезших из анекдотов про «новых русских» красномордых жлобах с турецкой золотой цепочкой, которые дают ценные советы по ведению бизнеса прямиком из тех лет, когда они начинали, а ты слушаешь и думаешь — ну господи, что ты несешь, от этих твоих «советов» работники в ужасе разбегутся, а потом еще и придет налоговая и даст пиздюлей. Впрочем, аргументированно возражать тоже не получится — потому что главный аргумент расказчика выражается фразой «если ты такой умный, где твои деньги?» Нет, можно быть вполне себе милым московским мальчиком с написанным на лице ВМК МГУ, и носить не малиновый пиджак, а интеллигентский свитерочек — но давать советы такого же космического масштаба и космической же глупости. Вот, например, Максим Лапшин, руководитель Flussonic, распедаливает нам, чем баг отличается от фиче-реквеста:

https://levgem.livejournal.com/508738.html

И разумеется, Максим считает себя очень умным, а описанную по ссылке жесть — несомненно правильной, и доказывается это тем, что у Flussonic’а клиенты есть и даже готовы платить за такое жлобское отношение — но что же мы узнаем из приведенного текста?

А узнаем мы очень простую вещь — «продукт» Flussonic полностью соответствует фразочке «A design without specifications cannot be right or wrong, it can only be surprising!» — а все потому, что в фирме у Лапшина писать хоть какую-то документацию для разрабатываемого софта не принято, чай, клиент не барин, сам поймет, баг это или фича. И действительно, в отсутствии спецификаций они различаются только субьективным отношением, «эмоциональной оценкой клиента». Добавляем к этому еще парочку «антипаттернов» уровня «документация делается техписом», «сотрудник поддержки, который заведомо ниже квалификации чем разработчик или продакт» (кстати, видите тут совершенно неприкрытый снобизм по отношению ко всем «непрограммистам» с «заведомо низкой квалификацией»?) — ну и видим, собственно, что ни при каких обстоятельствах принимать во внимание мнение Лапшина о том, «как должно быть», попросту нельзя.

В целом, конечно, это типичнейшая «история успеха», причем в худшей ее форме, когда замалчиваются приведшие к этому успеху случайности, а явные ошибки и антипаттерны объявляются образцом для подражания.

PS Найдите максимум «антипаттернов» в вот этом слащаво-рекламном тексте: https://web.archive.org/web/20170207041400/vc.ru/p/flussonic-tv

Ростех не мой, я только разместил объяву!

Репостнул в околопрограммистском чатике умеренно ватнической среднелюдоедской направленности вопрос (не мой), нет ли среди присутствующих кого-то, имеющего опыт конфигурации Ardupilot или чего-то аналогичного для ростеховского проекта. Один из программистов чатика мгновенно порвался и два дня фонтанировал бессвязными фразами про FPV-дроны, глушилки GPS, распилы, Мавики, СВО, Ланцеты, «они пилят, а там люди гибнут» и прочее в том же духе, перемежая это оскорблениями в адрес незнакомых ему людей.

Так вот, после двух дней бессвязной болтовни выяснилось, что проект не военный, не FPV, и Ardupilot нужен только для первых прототипов, но за это время программист написал много чего смешного, угорали двумя чатами одновременно. В свете этого хочу сказать главное для юных программистов: если вам выдали задачу, не бросайтесь ее решать с шашкой наголо, уточните важные детали, а то может так получиться, что домик нужно нарисовать для слепого жирафа.

Кто-то в лесу сдох

Издательство ДМК внезапно выпустило две более-менее вменяемых книги про встраиваемые системы. Во-первых, сначала я наткнулся на «Реверс-инжиниринг встраиваемых систем» Алексея Усанова. Не сказал бы, что раскрыты какие-то глубины этого процесса — но если рассматривать книгу, как каталог ссылок на всякие полезные материалы — то сойдет. В целом — нормальное дополнение к какому-нибудь учебному курсу по программированию встраиваемых систем — «как на ваше устройство смотрит недоброжелатель :)».

Во-вторых, поизучав другие издания на сайте, нашел перевод учебника Даниэле Лакамеры «Архитектура встраиваемых систем» — в отличие от массы литературы «по STM32», сводящейся к пересказу даташита вперемешку с многочисленными скриншотами из Cube MX, здесь описывают среду разработки с использованием gcc и make, работу с памятью «на низком уровне», немного затрагивают внешние сетевые интерфейсы и многозадачность — в общем, подходящий набор для того, чтобы не пугаться любого более-менее современного микроконтроллерного проекта, отличающегося от «а мы тут быстренько что-то под ардуину налабали».

На фоне того, что издают по программированию для разного мелкого embedded на русском языке (всякие там «77 бесполезных проектов на ардуине») — внезапно уровень очень неплох. Прямо даже задаешься вопросом — что же случилось (и кажется, логотип YADRO на обложке второй книги намекает, кому это может быть нужно).

Чем программист отличается от андроид-разработчика

На днях активно участвовал в некоем срачике — но программирование под Андроид там было фоном, поводом для встречи двух одиночеств — и эти персонажи в «околоайти» повторяются так часто, что стоит описать их подробнее.

https://mbr.livejournal.com/655769.html

Итак, в красном углу ринга — бывший советский инженер, ушедший в руководство, но более-менее сохранивший знания. Образование у такого персонажа может быть очень разным, не всегда инженерным (встречал тут много кого, в диапазоне от физиков до военных) — но всегда есть и общая эрудиция, и теоретические знания, и какой-то набор практических навыков, позволяющих быстренько прикинуть пути решения и сложность каких-то технических задач.

Понятно, что эти задачи надо как-то делегировать — но в голове у такого персонажа всегда есть мысль — «да делать там нечего, я бы сам за недельку-другую осилил, вот только некогда и руки не доходят». Если вдруг это ощущение «давненько я не брал в руки шашек» удачно совпадает с двухнедельным перерывом в текучке — то может сесть и сделать, может быть, слегка старомодно (давно вы видели десктопную разработку на Delphi? А некоторые до сих пор могут!) — но работать будет. Если же такого перерыва не предвидится — то делегировать придется под ворчание о том, что делать там нечего, да и вообще, зажрались эти программисты, два месяца собираются над такой ерундой работать!

В запущенном случае, это, конечно, принимает некоторую форму снобизма, особенно, если времени освежать знания не было, в духе «а нахера тут Cortex-M, ща я на PIC’овском ассемблере сбацаю, учись, студент, пока я жив!» — но в целом такой типаж повторяется с поразительной регулярностью, вот и топикстартер в той теме про андроид-приложение к нему относится.

В синем углу ринга — массовый современный программист, выпускник каких-то «курсов». Массовая подготовка имеет свои недостатки — большинство «курсов» готовят кадры для «галер», то есть контор, занимающихся разработкой типовых программных поделий. Об объеме знаний типового «андроид-разработчика» можно судить по украинскому опроснику для собеседований:

https://itvdn.com/ru/blog/article/250-about-android

Знания собственно платформы — минимальные, зато уделяется масса внимания «работе с сетью» — точнее, работе с операциями семейства CRUD через какой-нибудь REST API. В сочетании с неумением читать документацию — прекрасный кадр для решения простых повторяющихся задач, вроде «приложения со списком рецептов» из того же опросника. Что-то за пределами привычного круга задач моментально выбивает из колеи — примерно как описано по первой ссылке. С другой стороны, одинаковые «приложения» по рецепту «архитектура MVVP, работаем с REST API через Retrofit, получаем JSON, конвертируем в понятный вид с помощью Moshi» тоже кем-то востребованы, клиенты есть.

Андроидом, конечно, это все не ограничивается — в любой массовой айтишной специальности таких персонажей полно. Годиков через несколько они дорастают до «сеньоров», начинают играть в «собеседования» — и тем самым в основном плодят себе подобных. Ключевое, пожалуй — абсолютно нулевой кругозор и заточенность на решение простых типовых задач, в вырожденном случае — вообще не выходящих за рамки давно освоенных «курсов по программированию».

Встреча этих двух персонажей, разумеется, «результативно» закончиться не может — первый уверен, что все просто и программисты его дурят (это действительно так), вторые быстро понимают, что задача выходит за рамки привычного, потребует слишком много времени, а при этом, цитирую:

Они же эти умения потом никому больше не продадут. Это не просто потерянное время, когда можно было бы развивать скиллы, это время, когда ты изучаешь бесполезное, а мог бы изучть полезное. И потом уже не наверстать.

— так что сливаются под более-менее благовидным предлогом, мол, очень сложно.

Про принципы

Решил узнать, стою ли я чего-то, как «программист под Android», скорее всего, срежусь на первом же вопросе, про «основные принципы ООП»:

https://itvdn.com/ru/blog/article/250-about-android

С другой стороны, при чем тут Организация Освобождения Палестины?

А в этот раз — не про студентов

Скажу только, что такой говнокод пишет не Хундай, там ISO 26262 пока еще чтут :)

uint32_t cur_timestamp, last_timestamp;

cur_timestamp = GET_SECONDS() & UINT16_MASK;
last_timestamp = storage->timestamp;

if (last_timestamp + TIME_DELTA > cur_timestamp) {
    return;
} else {
    // do something
    storage->timestamp = (uint16_t) cur_timestamp;
}

Студентов я за такое бил по рукам спрашивал — а что будет с вашей программой через 71 минуту (когда так мучили 32-битный микросекундный таймер) или через 49 дней (таймер миллисекундный на этот раз, но те же 32 бита)? 16-битный счетчик секунд, кажется, это кококомбо, тут все встанет раком через 18 часов, это уже достаточно много, чтобы не заметить проблему при тестировании, но при этом достаточно мало, чтобы она ебала мозг в эксплуатации.

Про экономическую эффективность

Два дня протирал штаны в экзаменационной комиссии в Московском Институте Элегантных Мужчин (ныне являющемся частью Высшей Школы Этого-самого), защищались магистерские работы по специальности «Инфокоммуникационные технологии и системы связи». Уровень — в принципе, такой же, как и в прошлом году — из полутора десятков работ на «отлично» без вопросов тянули хорошо если четыре. Остальное было в диапазоне от весьма унылых «инженерных» работ («четверка с плюсом» в прыжке), причем местами студент даже с трудом понимал, что и зачем он делал, до уровня «в качестве диплома пытаются защитить акт покупки китайских датчиков с алиэкспресса» (почти точная цитата, только вот тут даже «облака» не было). За последнее в этот раз ставили «тройку с минусом», хотя, в принципе, будь у вуза яйца покрепче — надо было бы выгонять с неудом.

Но вот увидел я эту картинку — точнее, скриншот с рейтингом зарплат выпускников айтишных специальностей по разным вузам — и немного охуел. Московский Институт Элегантных Мужчин в рейтинге находится на 4 месте, напротив циферками обозначено 220 000 рублей.

Конечно, мои взгляды на рынок труда попахивают трудовой теорией стоимости, почерпнутой из пересказов Карла Маркса и Адама Смита — но среди выпускников за эти два дня я не увидел практически никого, кто мог бы «производить продукт», стоящий этак тысяч 300-400 в месяц (не забываем про все, что кырла-мырла относил к «прибавочной стоимости»). Более того, поразмыслив над одной из работ, я понял, что эта ваша айтишечка глубоко убыточна, но что самое страшное — никто из участников в принципе не осознает глубины этой дыры.

Собственно, работа родилась из простой гипотезы — в дождь количество заказов в службе экспресс-доставки возрастает, а количество доступных курьеров падает — поэтому надо как-то автоматически распознавать, когда в районе конкретного центра формирования заказа идет дождь, и принимать какие-то решения на основании этого (скажем, увеличивать минимальный чек для заказа, чтобы не «гонять раба» с одной бутылкой колы). Разумеется, для проверки этого предположения — а оно само по себе довольно сомнительно — никак нельзя воспользоваться, скажем, данными сторонних сервисов, типа того же Яндекса — поэтому была разработана и даже представлена в качестве дипломной работы очередная универсальная система перемещения данных слева направо:

Разумеется, сразу был предусмотрен жуткий хайлоад — ведь 3000 центров формирования заказов, в каждом из которых стоит метеостанция, раз в секунду отправляющая данные о погоде, это не ишак чихнул, тут все эти названия и аббревиатуры однозначно нужны! Кстати, если чуть-чуть подумать мозгом — то этот «раз в секунду» совершенно не нужен, достаточно, к примеру, раз в 10 минут — и тогда весь ваш хайлоад усыхает до 5 RPS. Это, кстати, было первое предложение от комиссии :)

Но давайте посмотрим на это все хотя бы даже с точки зрения пилотного запуска на десятке центров формирования заказов. Во сколько обойдется человекомесяц работы программиста и девопса (смотрим в верхнюю табличку!), закупка и установка оборудования, прочие капексы и опексы за некоторый период? Что-то мне подсказывает, что можно легко вылететь за сумму в миллион рублей — а результат будет явно несопоставим.

В очередной раз убеждаюсь в том, что современная айтишечка под видом «решения проблем бизнеса» занимается, по сути, вымогательством. Интересно, а если бы в том дипломе была главка про экономическую эффективность — не вышло бы так, что разработанное решение имеет отрицательную ценность?

Драма в десяти коммитах

Кажется, сегодня был свидетелем драмы, выраженной в гитовских commit message.

В общем, сдавала мне студентка некое задание, этакий hello world для встраиваемых систем, только он у нее не запускается и не компилируется. Я помню, что вносил в основной репозиторий проекта, с которым они работают, некие правки, и без задней мысли решил посмотреть git log — не забыла ли девочка их подтащить?

В логе — прекрасная картина, последние пара коммитов девочкины, относительно свежие, дальше идут подписанные мужским именем и прямо видно, как у человека нарастала экспрессия — вплоть до «fucking shit fixed!!11». Поинтересовался, конечно, что это за чувак, выяснилось, что студенткин молодой человек. И в общем меня волнует одно — а почему он в марте что-то делал, а в апреле и мае девочка пользовалась Stackoverflow и ChatGPT? Неужели они расстались из-за ебучей Riot OS?

ChatGPT и программирование

Увидел сегодня очень показательный пример того, как ChatGPT «пишет» программы. В общем, очередной раз читаю курс по программированию всяких встраиваемых устройств, и ближе к концу семестра, осознав весь зашитый в формулу для оценок фашизм, нарисовалась студентка с желанием сдать все и сразу, включая задания, по которым дедлайн уже прошел. Решил посмотреть код — и заподозрил неладное. Но сначала — давайте я покажу его вам в слегка сокращенном виде, найдете ли вы здесь какие-то ошибки?

#include <stdio.h>
#include "periph/i2c.h"
#include "periph/gpio.h"
#include "periph_conf.h"
#include "bme280.h"

int main(void)
{
    /* Инициализация датчика BME280 */
    bme280_t bme280_dev;
    int bme280_res = bme280_init(&bme280_dev, I2C_DEV(0), BME280_I2C_ADDRESS);
    if (bme280_res != 0) {
        printf("Ошибка инициализации BME280: %d\n", bme280_res);
        return 1;
    }

    /* Получение и вывод показаний датчиков */
    while (1) {
        /* Получение показаний BME280 */
        bme280_measure(&bme280_dev);
        float bme280_temperature = bme280_temp_comp_2(&bme280_dev, bme280_dev.temperature);
        float bme280_humidity = bme280_humid_comp(&bme280_dev, bme280_dev.humidity);
        float bme280_pressure = bme280_pres_comp(&bme280_dev, bme280_dev.pressure);

        printf("BME280: температура=%.1f°C, влажность=%.1f%%, давление=%.1f мбар\n",
            (double)bme280_temperature, (double)bme280_humidity, (double)bme280_pressure);
        }
        xtimer_sleep(5);
    }

    return 0;
}

Меня сразу смутил используемый для работы с датчиком (банальный BME280) API — он очень отдаленно напоминал реализованный в Riot OS, не говоря уж о библиотеке для Arduino или ARM mbed, или о «фирменном» бошевском драйвере. Но еще больше удивил соседний файл (с кодом, который якобы написан той же самой студенткой!), где работа с датчиком выглядела примерно так (опять же, в максимально сокращенном виде):

#include "xtimer.h"
#include "bme280.h"

#define BME280_DEV  I2C_DEV(0)

static bme280_t dev_bme280;

int main(void)
{
    int8_t res;
    res = bme280_init(&dev_bme280, BME280_DEV);
    if (res != BME280_OK) {
        puts("Could not initialize BME280 sensor");
        return 1;
    }

    while (1) {
        float temperature_bme280;
        bme280_read_temperature(&dev_bme280, &temperature_bme280);
        printf("BME280 temperature: %0.1f C\n", temperature_bme280);
        xtimer_sleep(5);
    }

    return 0;
}

Видите что-то общее? Вот и я не вижу. При этом в принципе оба варианта API мне представляются вполне обоснованными (во всяком случае, я мог бы сказать, зачем я так сделал), но этот код очевидно не скомпилируется и работать не будет. Но внешне — все выглядит довольно неплохо, названия функций, какое-то подобие семантики вызовов — все правдоподобно, но…

В общем, вы понимаете то чувство, когда ты думаешь, что со студенткой разговаривал, а на самом деле — с большим тараканом, с жуком-оборотнем.

Решил проверить догадку самостоятельно и задал ChatGPT вот такую задачу: Write a C language program for RIOT OS that uses a BME280 sensor connected by I2C bus, reads temperature, pressure and humidity values from the sensor and outputs them into UART each 10 seconds. Also, if the temperature is higher than 100 degrees Fahrenheit, a LED connected to one of GPIO pins must be switched on. When the temperature lowers, the LED is switched off.

Я думаю, вы уже догадались, что было ответом — правильно, третий вариант API! (но с градусами Фаренгейта я хорошую подставу придумал):

#include "bme280.h"
#include "periph/gpio.h"
#include "periph/i2c.h"
#include "periph/uart.h"
#include "xtimer.h"

#define I2C_DEV     (I2C_DEV(0))
#define BME280_ADDR (0x76)

#define LED_PIN     (GPIO_PIN(PORT_A, 5))
#define LED_ON      (0)
#define LED_OFF     (1)

static bme280_t dev;
static gpio_t led;

static void init(void)
{
    i2c_init(I2C_DEV);
    bme280_init(&dev, I2C_DEV, BME280_ADDR);
    uart_init(UART_DEV(0), 115200, UART_FLAG_NONE);
    gpio_init(LED_PIN, GPIO_OUT);
}

int main(void)
{
    init();

    while (1) {
        bme280_read_fixed(&dev);

        printf("Temperature: %ld.%02lu C\n", dev.temperature / 100, dev.temperature % 100);
        printf("Pressure: %lu.%02lu hPa\n", dev.pressure / 100, dev.pressure % 100);
        printf("Humidity: %lu.%02lu %%\n", dev.humidity / 1024, (dev.humidity * 100) / 1024 % 100);

        if (dev.temperature > 100 * 100) {
            gpio_write(led, LED_ON);
        } else {
            gpio_write(led, LED_OFF);
        }

        xtimer_sleep(10);
    }

    return 0;
}

Но вот что интересно — так это время, которое пройдет между написанием кода и обнаружением наебалова. Принято считать, что одна из сложностей в эмбеддеде всех мастей — это долгий цикл обратной связи между написанием кода и получением результата — работает/не работает/надо переделать. Так вот, для наебалова в таком вот духе он сокращается до одной команды в консоли — наберите make flash и тут же, не отходя от кассы, получите тугую струю ссанины в ебало в виде совершенно невнятных ошибок компилятора. А вот если у вас модный язык вроде Javascript или Python — то с вот таким синтаксически корректный бредом можно долго и плодотворно заниматься debugging into existence. Программист программировает, получька капает.

Будующее такое яркое.